一条失败的 trace 只进一个格子。行 = 最后做对的一步,列 = 第一处做错的一步。
agent 出了问题,读了二十条 trace,手里一堆笔记,却说不出该先修哪里。Hamel Husain 和 Shreya Shankar 在 AI Evals FAQ 里给的汇总工具叫转移失败矩阵(transition failure matrix)。前半篇是原方法,后半篇是我在自己项目里套用时想清楚的扩展,原文没讲的部分会标出来。
原方法:先判成败,再看步骤
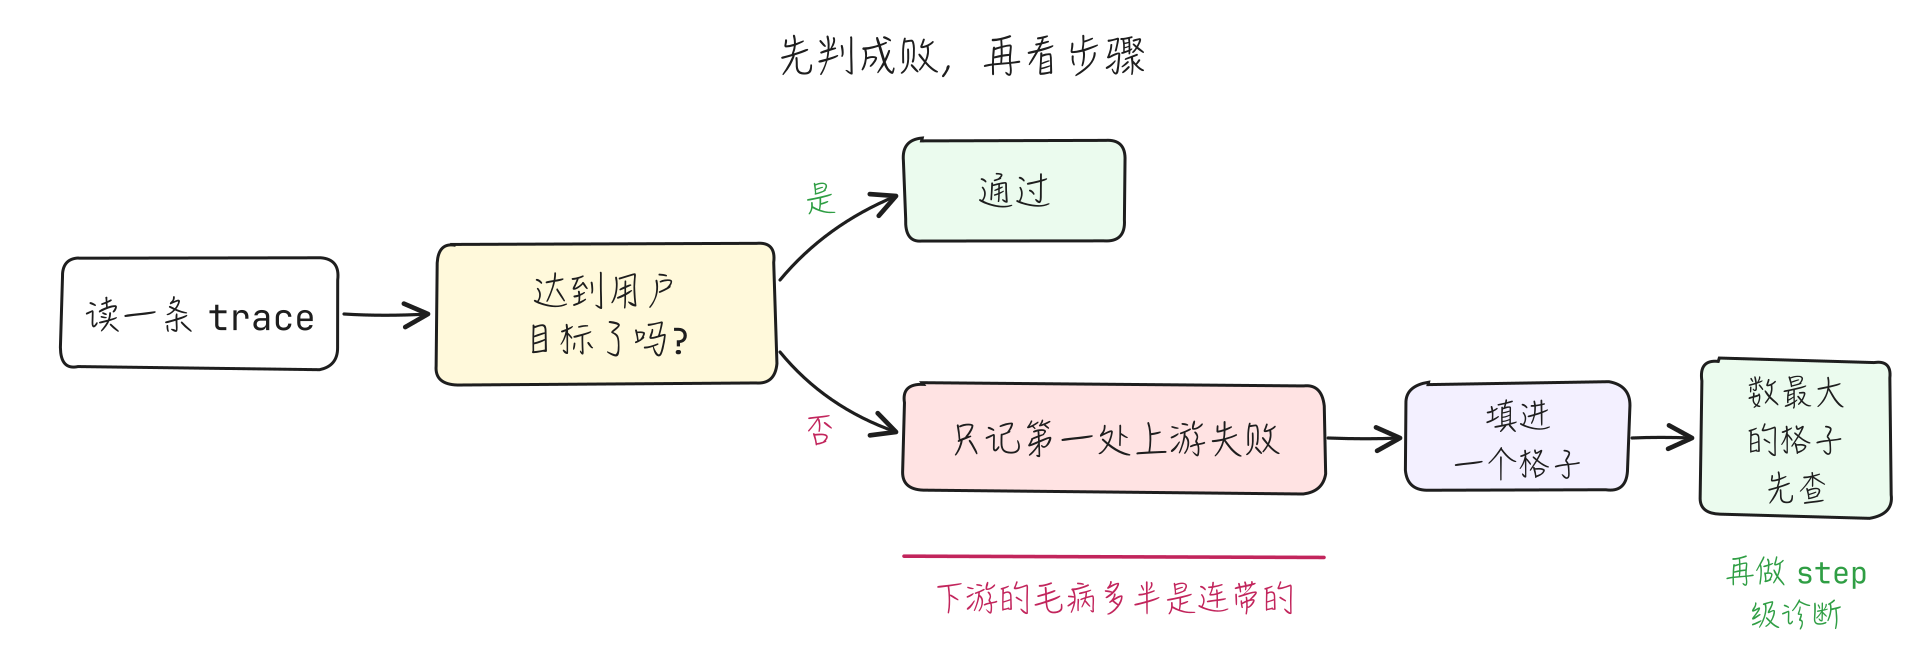
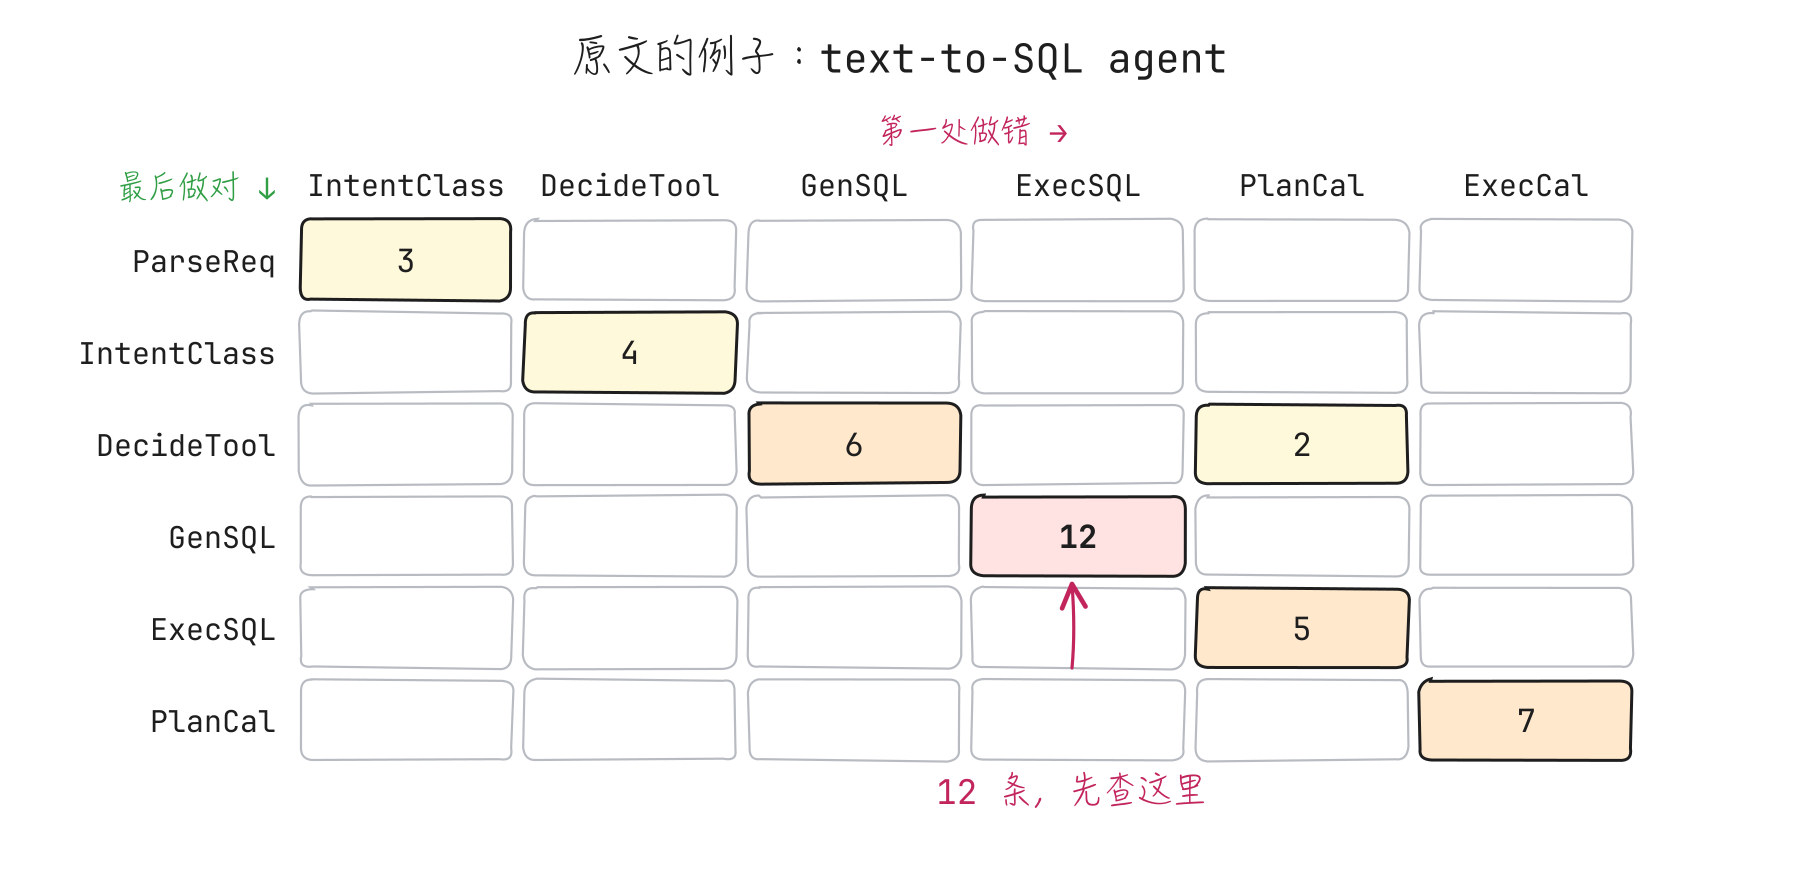
GenSQL → ExecSQL 有 12 条,先查这里。
它其实是状态机的邻接矩阵
行列是状态,一个格子是一条转移。想明白这一点,循环就不是特例了。
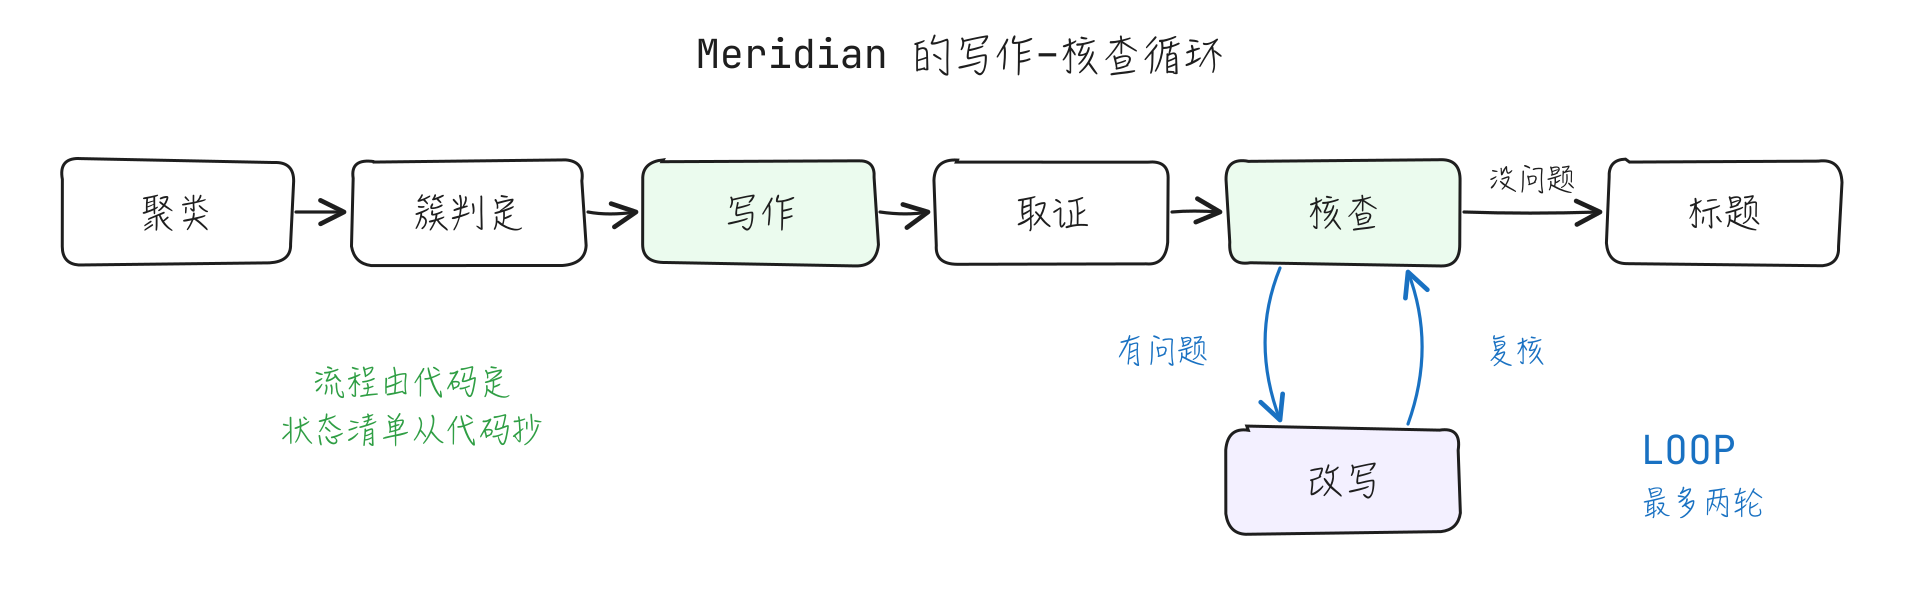
我的项目 Meridian 是一个新闻简报系统,里面有一个写作–核查循环,也就是 Anthropic 说的 evaluator-optimizer:一个 LLM 生成,另一个评估并反馈,循环往复。
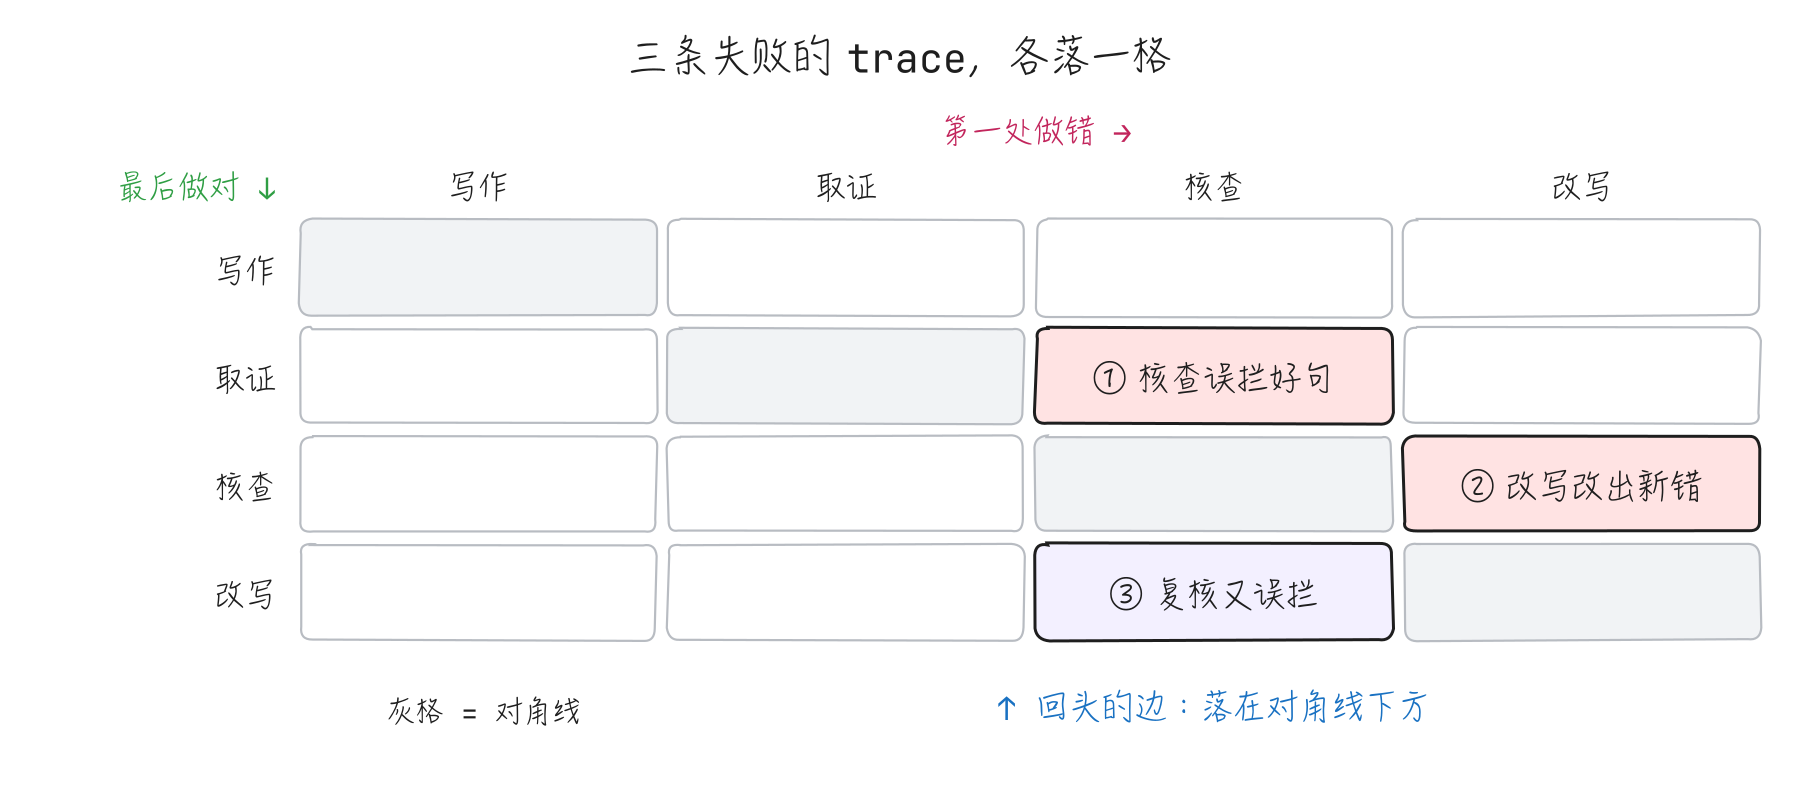
③ 落在对角线下方,这就是循环那条回头的边。原文的例子只有对角线上方有数,是因为那个流程恰好是直线。
矩阵只回答断在哪条转移上。同一步的不同错法(核查漏掉真错、核查误拦好句)记在同一列,进了格子再分。
每一步对不对,不能看日志
核查把一句好话判成了「有问题」:
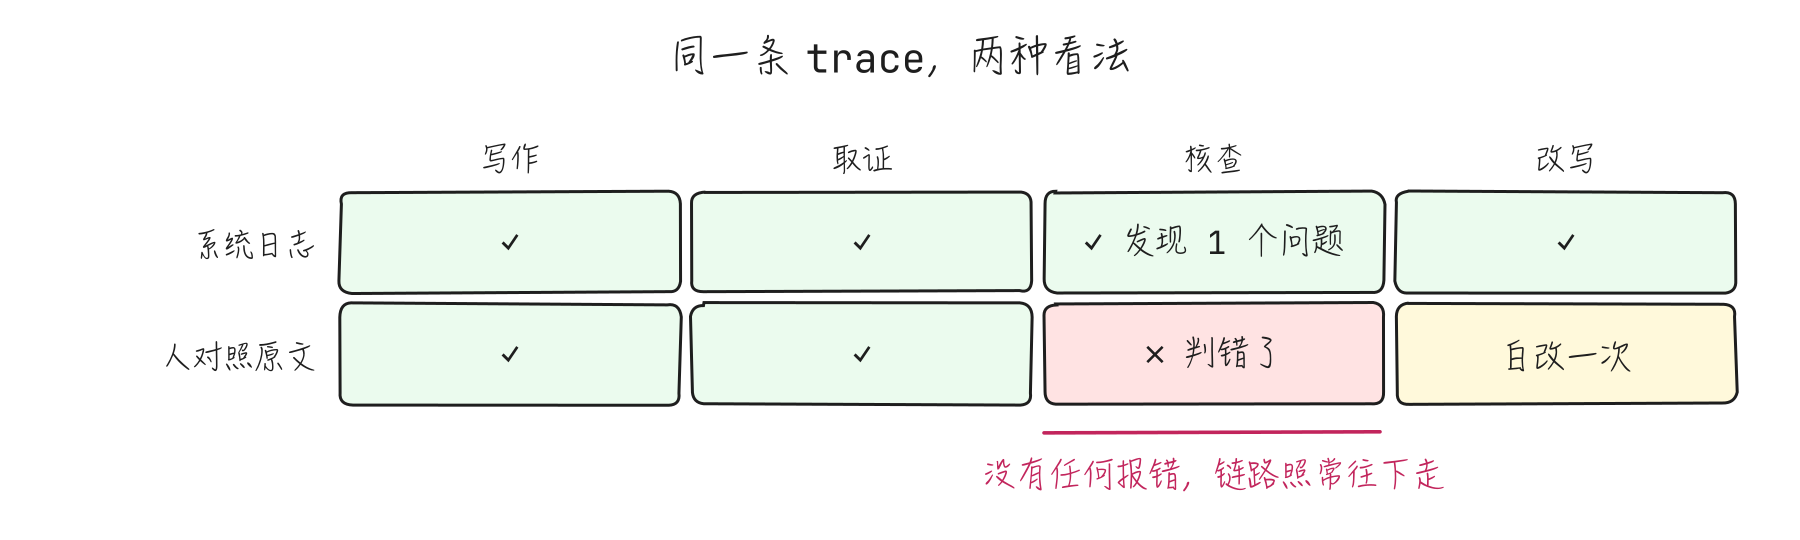
没有报错,链路照常往下走。按日志填矩阵,会得出「核查从不失败」。每一步的成败只能由读 trace 的人判。
让 LLM 替你判也还不行。Who&When(ICML 2025)专门测自动定位失败,最好的方法读数如下:
| 要找的东西 | 准确率 |
|---|---|
| 哪个 agent 负责 | 53.5% |
| 错在哪一步(decisive error step) | 14.2% |
论文里的 decisive error step,就是这里说的第一处上游失败。
从 workflow 到 agent,做法一样
Anthropic 的定义:workflow 是 LLM 和工具走预先写好的代码路径;agent 是 LLM 自己动态决定流程和工具使用。上面的写作–核查循环是 workflow,下面这个是 agent。
Meridian 的核查曾经是一个小 agent,四个工具,先用哪个、用几次都由模型定:
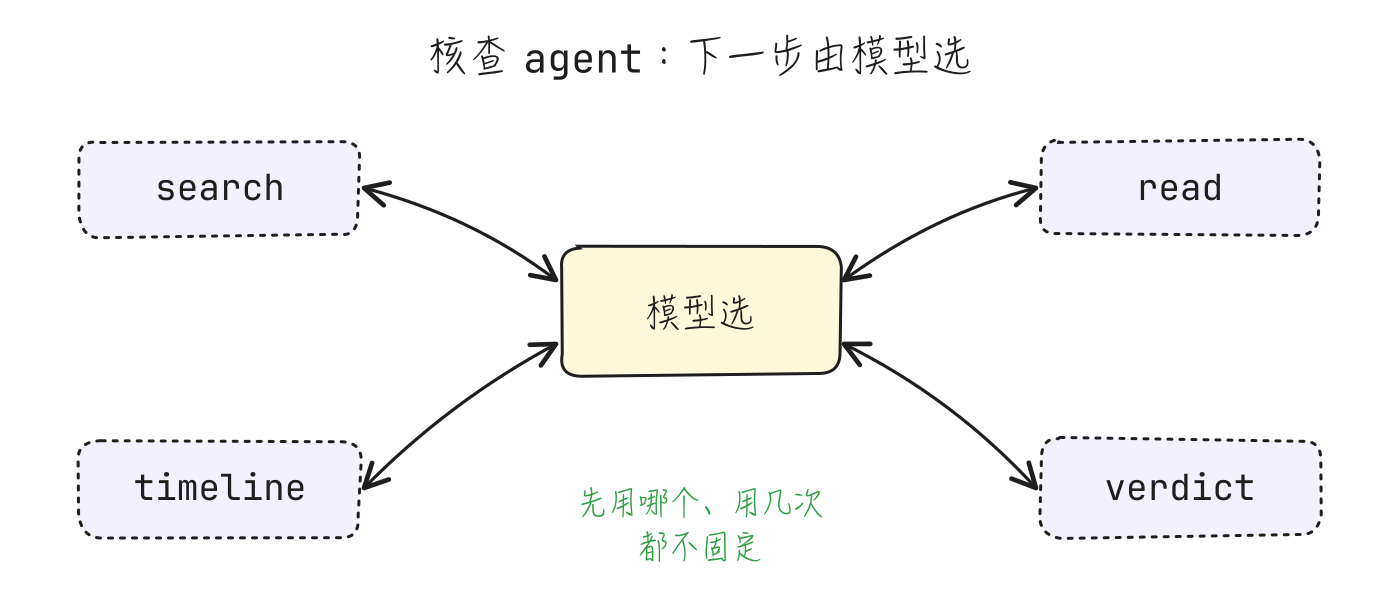
选路是运行时的事。跑完之后,一条 trace 仍然是一串排好顺序的步骤:
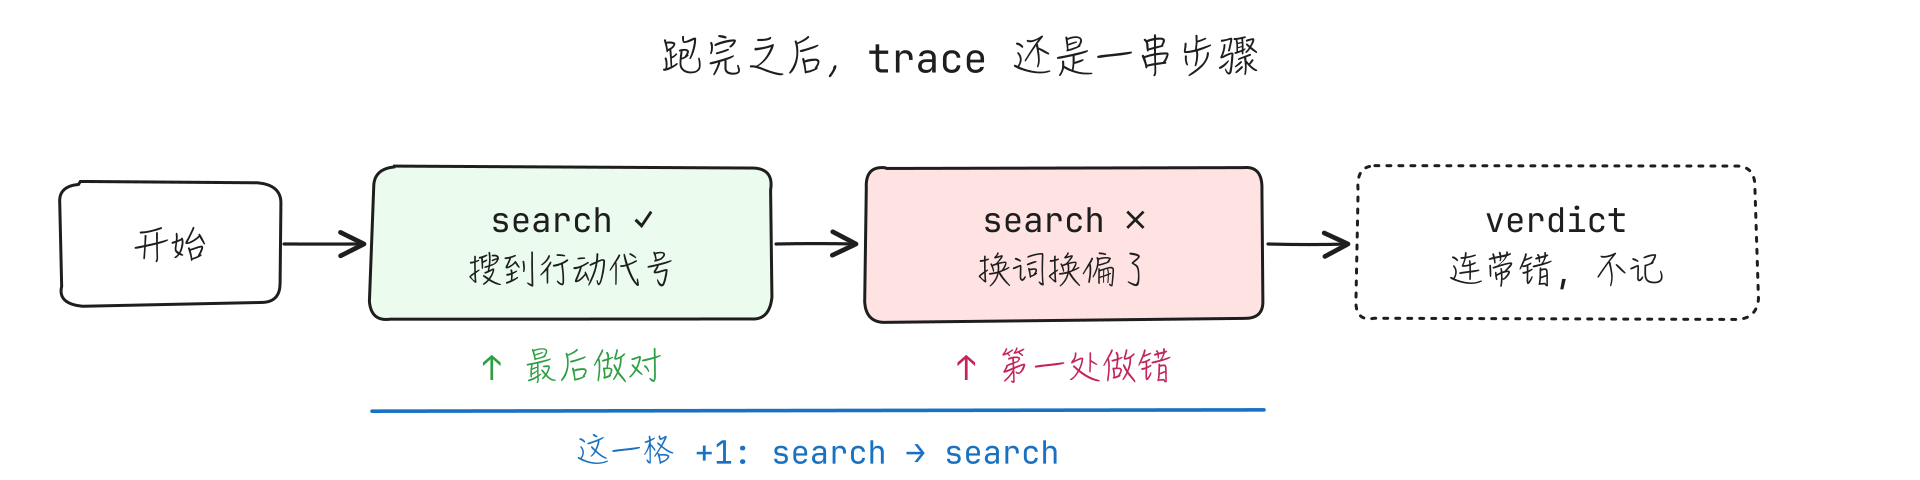
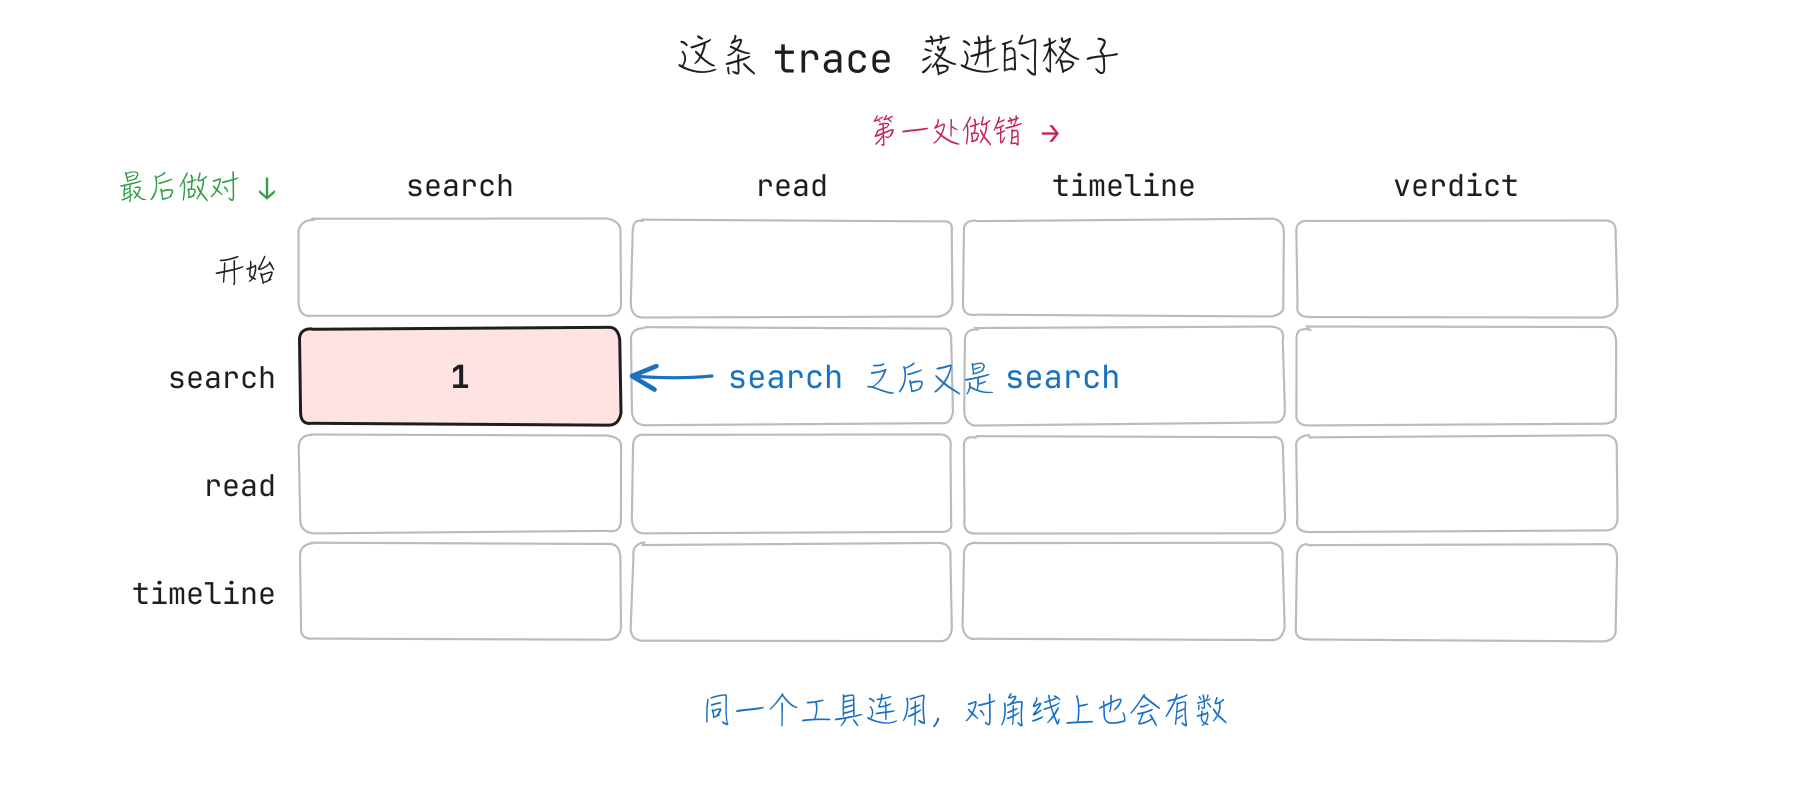
和 workflow 比,只有三处不同:
| workflow | agent | |
|---|---|---|
| 状态清单 | 从代码抄 | 工具名,加一行「开始」 |
| 对角线 | 空 | 有数(同一工具连用) |
| 数的分布 | 集中在几格 | 散开,要读更多条 |
工具很多、agent 嵌在 workflow 里:粗粒化与分块
这一节是我自己的推演。原文只说了一句:矩阵怎么组织取决于你的应用。
工具很多时,先合并。
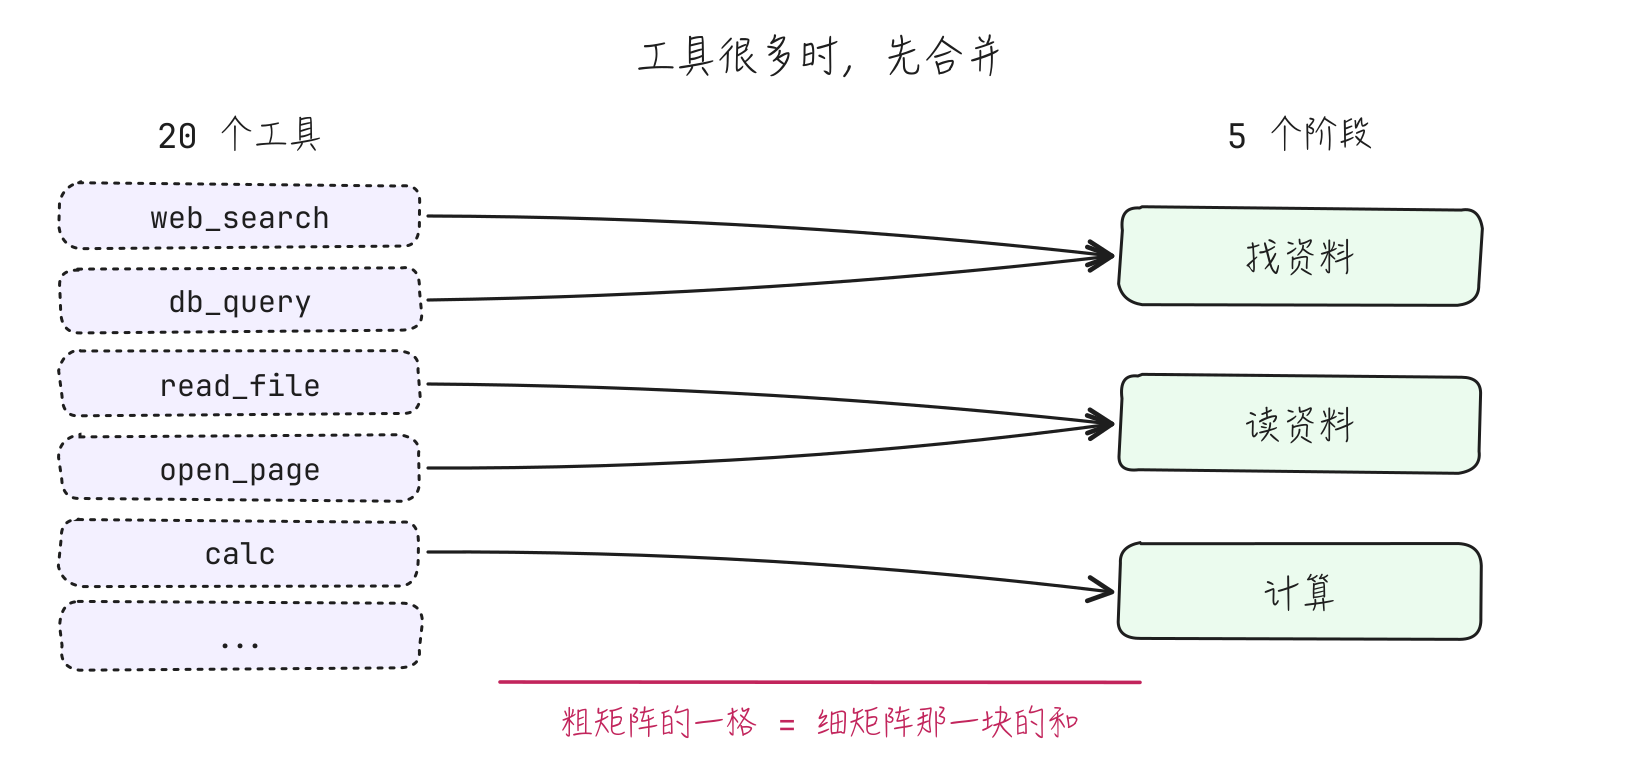
小 agent 嵌在 workflow 里时,看成分块矩阵。
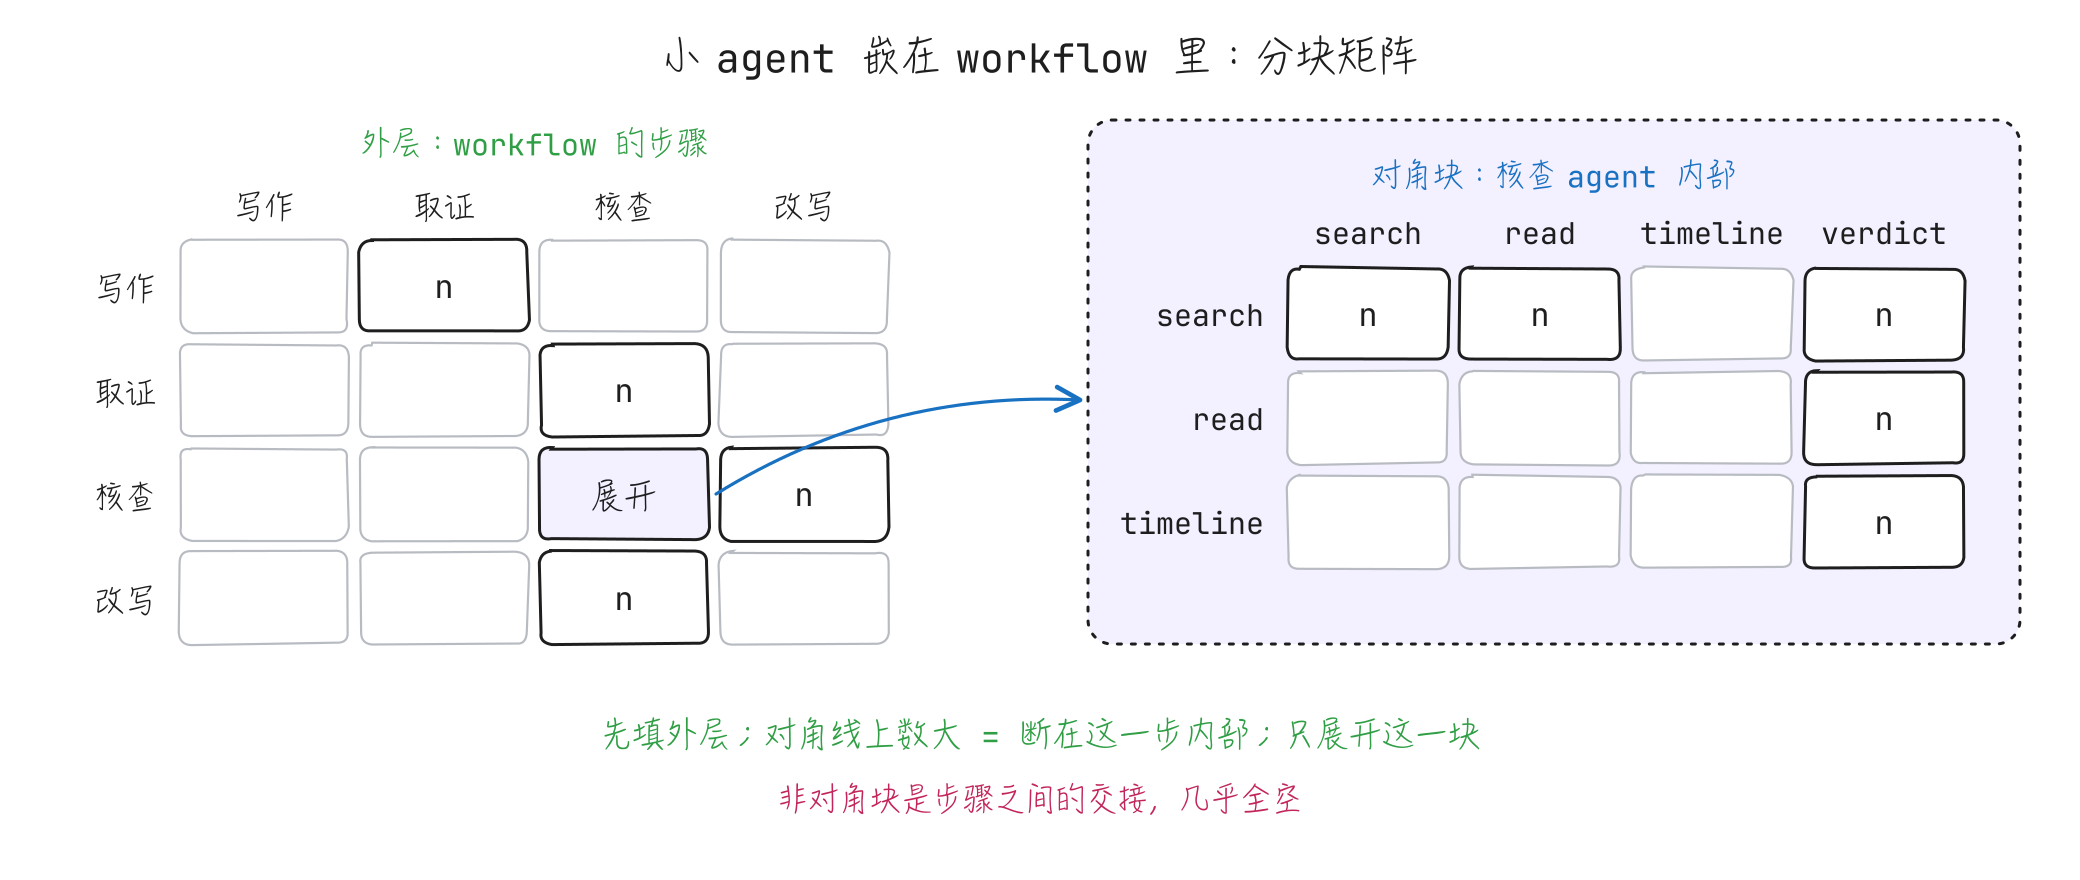
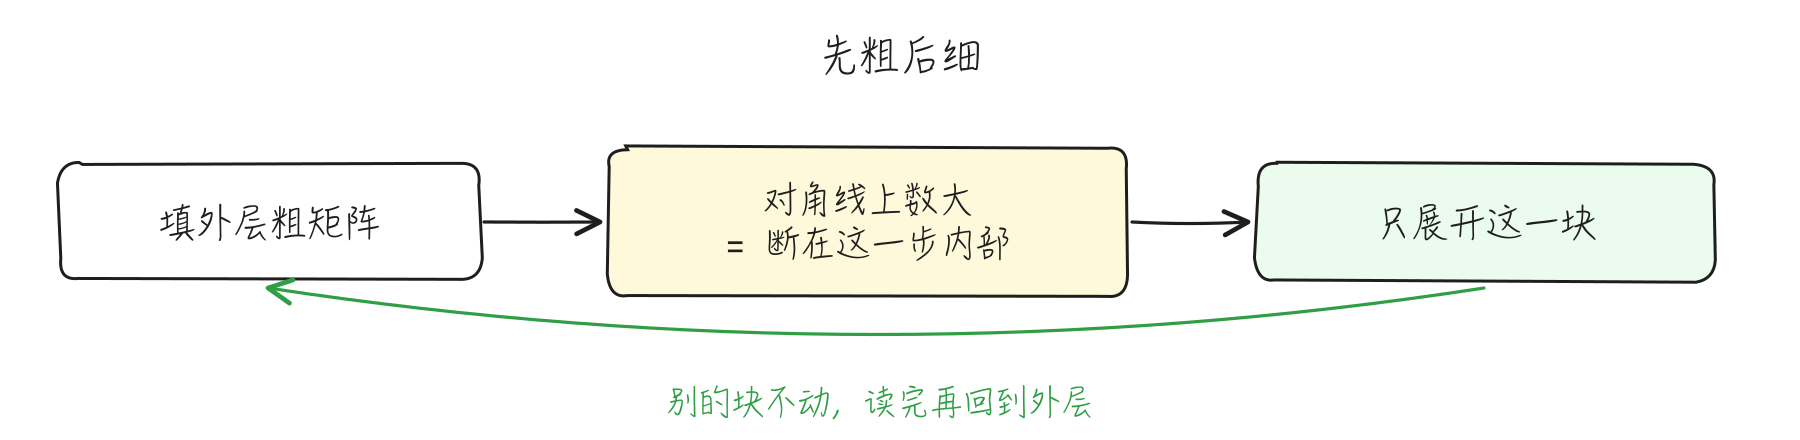
注意:数学里分块只是换个写法,随时能还原。这里不行:标注时只记了粗状态,细的信息就没留下。读 trace 时笔记里顺手写下具体断在哪个工具,汇总时再决定用粗的还是细的。
矩阵不表达什么
| 留下 | 丢掉 |
|---|---|
| 最后做对的是哪步 | 前面走了什么路 |
| 第一处做错的是哪步 | 这是第几次调用 |
这是有意的取舍,它只回答先去哪里查。顺序重要时两个补法:
- 把顺序写进状态名。
search拆成「第一次搜」和「再次搜」。状态会变多,只在怀疑顺序有影响时才拆。 - 进了热点格子再读原始 trace。 某一格有 12 条,就把这 12 条拿出来逐条读,看完整路径有什么共同点。这就是原方法的第二步。
小结
- 矩阵是标注的产物。先逐条读、定位第一处失败,才有东西可填。
- 它是状态机的邻接矩阵,循环和重复调用都是普通格子。
- 每一步的成败由人判,不看日志。
- 状态先粗后细,只在有数的地方细。
- 它只负责指路,到了地方还是要读 trace。
延伸阅读
| 工作 | 做了什么 | 补上本文哪一块 |
|---|---|---|
| MAST(UC Berkeley,NeurIPS 2025) | 多 agent 失败分类法:14 种失败模式,3 大类(系统设计、agent 间不对齐、任务验证),标注一致性 κ = 0.88 | 格子里的第二层分类,可以从它起步 |
| Who&When(ICML 2025) | 自动定位「哪个 agent、哪一步」出错的基准,127 个多 agent 系统的失败日志 | 定位出错步骤目前只能靠人 |
| TRAIL(Patronus AI,2025) | 148 条人工标注的 agent trace,测 LLM 调试 trace 的能力,最好的模型得分 11% | 同上 |
| Automata from Agent Traces(ICML 2026) | 把一批 agent trace 合并成一个有限状态机:12 个数据集上只有 7–43 个状态;按状态特征预测失败,AUROC 最高 0.94 | agent 事后看也是个不大的状态机;矩阵可以从事后诊断走向运行时预警 |
参考
- Hamel Husain & Shreya Shankar, How do I evaluate agentic workflows?
- Hamel Husain & Shreya Shankar, How do I debug multi-turn conversation traces?
- Bryan Bischof, Failure is A Funnel, Data Council 2025
- Anthropic, Building effective agents
- Zhang et al., Which Agent Causes Task Failures and When? On Automated Failure Attribution of LLM Multi-Agent Systems, ICML 2025
- Cemri et al., Why Do Multi-Agent LLM Systems Fail?, NeurIPS 2025
- Patronus AI, TRAIL: Trace Reasoning and Agentic Issue Localization, 2025
- Cho et al., Automata from Agent Traces: Failure and Next-Step Prediction, ICML 2026